Claude lässt sich über die API messen. Nur nicht mit Sonnet.

Jim Wrubel
10/2/2026
Claude ist der KI-Assistent, der beim Sichtbarkeits-Tracking am leichtesten wegfällt. Von claude.ai gibt es keine abgemeldete Version, die man abfragen könnte. Jede getrackte Antwort ist also ein bezahlter API-Aufruf, und diese Kosten wachsen mit jedem Prompt, jedem Standort und jedem Tag. Wenn Claude überhaupt getrackt wird, liegt es nahe, die Kosten mit einem kleineren, günstigeren Modell zu senken.
Damit entsteht ein wachsender blinder Fleck. Laut Similarweb stieg Claudes Anteil an den weltweiten Besuchen auf Websites generativer KI-Chatbots zwischen Juni 2025 und Mai 2026 von etwa 2 % auf knapp 9 %. Zudem ähneln Claudes Nutzer stark den Menschen, an die B2B-Marken verkaufen. Unter den rund 9.700 Claude-Nutzern einer aktuellen Umfrage von Anthropic arbeiteten etwa 30 % in Computer- und Mathematikberufen, gegenüber 4 % der Beschäftigten in den USA, und 23 % im Management, gegenüber 7 %.
Unser Forschungsteam hat deshalb die zwei Fragen getestet, an denen sich entscheidet, ob man Claude-Tracking über die API vertrauen kann. Kann ein API-Aufruf einen echten Menschen ersetzen, der claude.ai nutzt? Und funktionieren die günstigeren Modelle genauso gut? Die Antwort auf die erste Frage lautet ja, wenn Sie Opus 5.5 verwenden, das Modell, das claude.ai jetzt standardmäßig nutzt. Die Antwort auf die zweite lautet nein. Sonnet und Haiku nannten messbar andere Marken. Die vollständige Studie ist präregistriert, die Daten sind öffentlich. Hier ist, was das für Sie bedeutet.
Die wichtigsten Erkenntnisse
- Claude lässt sich über die API tracken, solange der Aufruf Opus 5.5 nutzt, das Standardmodell von claude.ai. Opus 5.5 kam bei den genannten Marken nah an claude.ai heran.
- Sonnet und Haiku sind kein Ersatz für claude.ai. Jede Sonnet- und Haiku-Konfiguration, die wir getestet haben, nannte bei derselben Frage zu B2B-Software andere Marken als claude.ai.
- Die günstigeren Modelle sparen kaum Geld. Nach unseren Schätzungen kostet Opus 5.5 ohne Systemprompt pro Aufruf ungefähr so viel wie Sonnet.
- Eine geleakte Kopie des claude.ai-Systemprompts machte Opus 5.5 deutlich teurer, ohne die genannten Marken nennenswert zu verändern.
- Die Reasoning-Stufe in claude.ai ändert die Marken nicht. Die höhere Stufe suchte häufiger, nannte aber dieselben Marken.
- Spyglasses trackt Claude jetzt mit Opus 5.5, in der Konfiguration, die in dieser Studie am nächsten an claude.ai lag.
Die Studie
Jede Claude-Sichtbarkeitszahl beruht auf einer Entscheidung: Welches Modell mit welchen Einstellungen steht stellvertretend für einen echten Menschen, der etwas in claude.ai eintippt? Diese Entscheidung wollten wir messen, mit Kosten.
Das Team hat 40 Kauffragen in 20 Softwarekategorien geschrieben, etwa CRM, Lohnabrechnung und Endpoint Security. Die Hälfte fragt nach einer Shortlist für ein beschriebenes Unternehmen. Die andere Hälfte fragt, wie sich die führenden Optionen für einen beschriebenen Bedarf vergleichen. Eine Person hat jede Frage an drei Tagen (27. und 29. September sowie 1. Oktober) von Hand in claude.ai gestellt, über ein neues Pro-Konto mit ausgeschaltetem Gedächtnis und ohne Personalisierung.
An denselben Tagen liefen dieselben Fragen über sieben API-Konfigurationen: Opus 5.5 und Sonnet 5, jeweils ohne Systemprompt und mit einer geleakten Kopie des claude.ai-Systemprompts aus einer öffentlichen Sammlung; eine Sonnet-Variante mit niedrigem Aufwand; Haiku 4.5; und unsere eigene Produktionsanfrage. Insgesamt wurden 1.080 Antworten in dieser Studie ausgewertet.
Wir haben verglichen, welche Marken jede Antwort nannte und welche Websites sie zitierte, mit einem Überschneidungswert. Stellen Sie ihn sich als den Anteil der Marken vor, die zwei Antworten gemeinsam haben, von 0 (nichts gemeinsam) bis 1 (dieselben Marken).
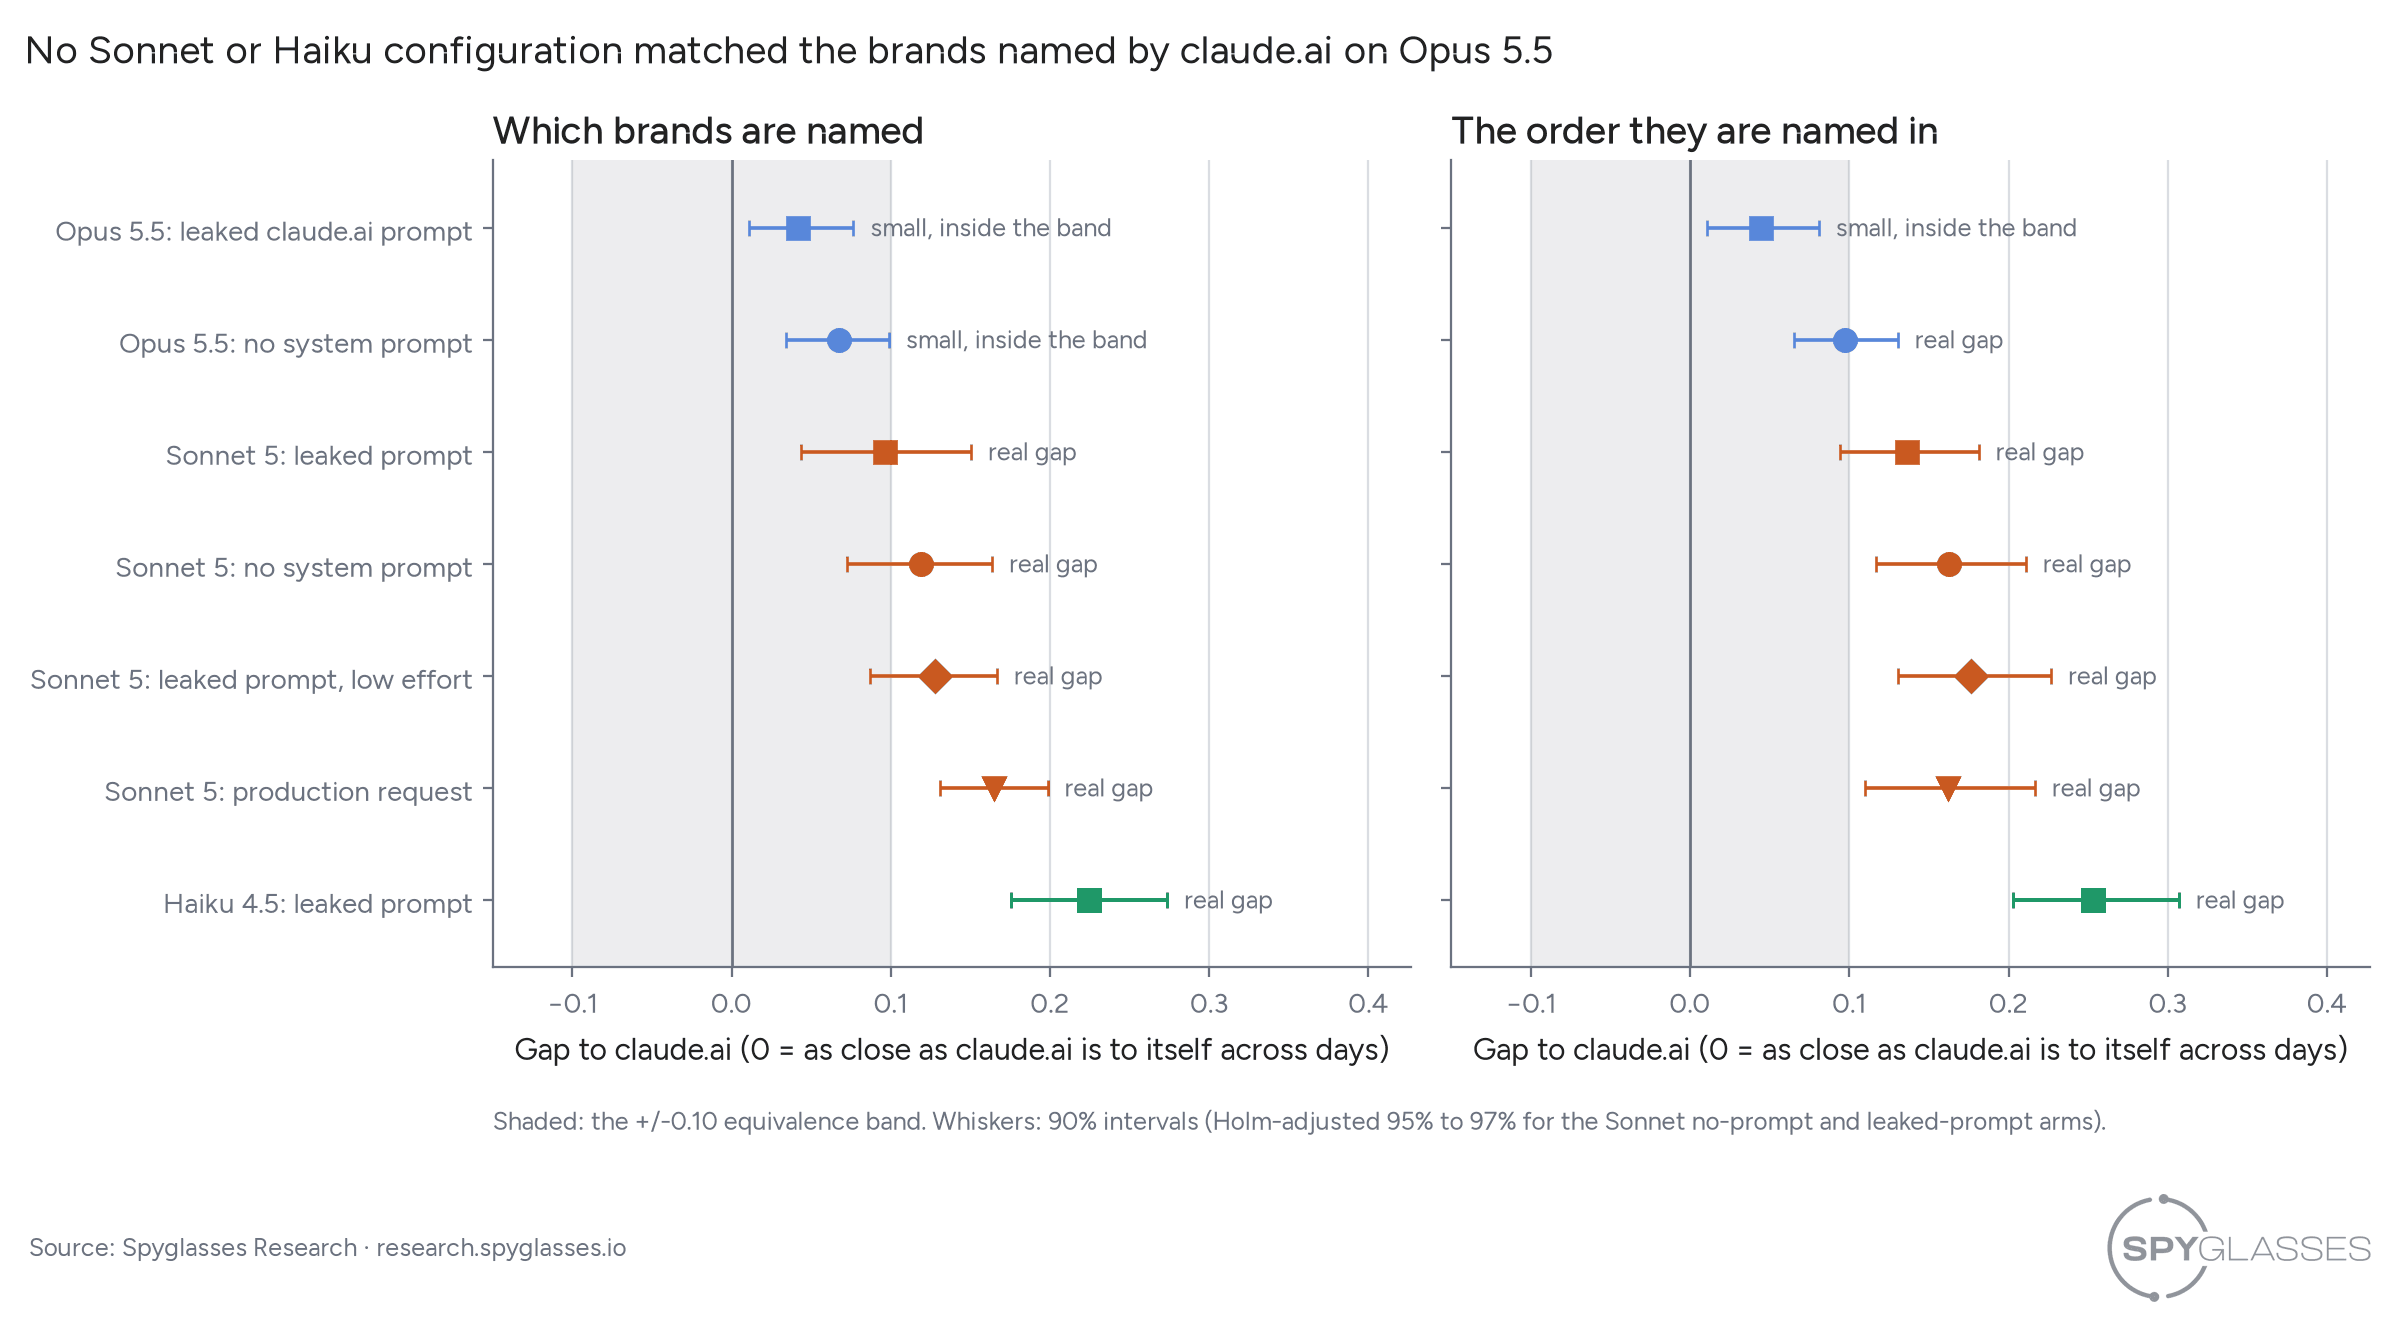
Der Maßstab war claude.ai selbst. claude.ai gibt nie zweimal dieselbe Antwort, also haben wir zuerst gemessen, wie gut es bei derselben Frage von einem Tag zum nächsten mit sich selbst übereinstimmt. Seine Markenüberschneidung mit sich selbst lag bei 0,643. Eine API-Konfiguration besteht, wenn sie mit claude.ai ungefähr so gut übereinstimmt wie claude.ai mit sich selbst. Den Abstand dazu nennen wir die Lücke. Vor der Datenerhebung haben wir die Toleranz auf 0,10 festgelegt. Bei zwei Antworten, die zusammen etwa zehn Marken nennen, entspricht das ungefähr einer ausgetauschten Marke.
Was wir gefunden haben
| Konfiguration | Markenlücke zu claude.ai | Ergebnis |
|---|---|---|
| Opus 5.5, geleakter claude.ai-Prompt | 0,042 | Klein, innerhalb der Toleranz |
| Opus 5.5, ohne Systemprompt | 0,067 | Klein, innerhalb der Toleranz |
| Sonnet 5, geleakter claude.ai-Prompt | 0,097 | Echte Lücke, am Rand |
| Sonnet 5, ohne Systemprompt | 0,119 | Echte Lücke |
| Sonnet 5, geleakter Prompt, niedriger Aufwand | 0,128 | Echte Lücke |
| Sonnet 5, unsere frühere Produktionsanfrage | 0,165 | Echte Lücke |
| Haiku 4.5, geleakter claude.ai-Prompt | 0,224 | Echte Lücke |
Sonnet und Haiku nennen andere Marken
Jede Sonnet-5-Konfiguration nannte bei derselben Frage messbar andere Marken als claude.ai. Das galt ohne Systemprompt, mit dem geleakten claude.ai-Prompt, bei niedrigem Aufwand und für unsere eigene Produktionsanfrage. Haiku 4.5 lag noch weiter daneben.
Die nächstgelegene Sonnet-Konfiguration verdient einen genaueren Blick. Mit dem geleakten Prompt lag ihre Lücke bei 0,097, direkt am Rand der Toleranz, und die Daten lassen eine Lücke von bis zu 0,15 zu. Das ist ein fehlender Nachweis der Übereinstimmung, kein Beweis für eine große Lücke. Aber ein Ersatz muss zeigen, dass er nah genug ist, und dieser konnte es nicht.
Das Modell selbst zählt. Als Sonnet 5 und Opus 5.5 ohne Systemprompt identische Anfragen bekamen, lag die Markenüberschneidung von Sonnet mit claude.ai um 0,052 niedriger. Das Modell allein erklärt einen messbaren Teil der Lücke.
Opus 5.5 über die API kommt nah heran
Beide Opus-Konfigurationen landeten innerhalb der Toleranz, bei 0,067 ohne Systemprompt und 0,042 mit dem geleakten Prompt. Der Unterschied zwischen beiden betrug 0,025, klein und innerhalb der Toleranz. Der geleakte Prompt erhöht vor allem die Kosten.
Bei einer Sache half er doch: bei der Reihenfolge der Marken. Bei einem Wert, der die zuerst genannten Marken stärker gewichtet, hatte Opus ohne Systemprompt eine Lücke von 0,097, eine echte Lücke direkt am Rand. Mit dem geleakten Prompt lag die Lücke bei 0,044.
Damit ist Opus 5.5 über die API ein vernünftiger Ersatz für claude.ai. Es kommt bei den genannten Marken nah heran und bei ihrer Reihenfolge etwas weniger.
Die Reasoning-Stufe ändert die Marken nicht
In claude.ai können Abonnenten das Reasoning von Medium, der Standardeinstellung, auf High anheben. High suchte etwa doppelt so oft, 2,5 Suchen pro Antwort gegenüber 1,2, und zitierte 6,8 Websites pro Antwort gegenüber 4,4. Es nannte dieselben Marken. Unser präregistrierter Test fand den Unterschied zwischen beiden Stufen so klein, dass er als keiner gelten kann. Um die Marken von claude.ai zu treffen, muss ein Tracking nicht die Reasoning-Stufe nachbilden. Es muss aber das Modell treffen.
Die Überraschung bei den Kosten
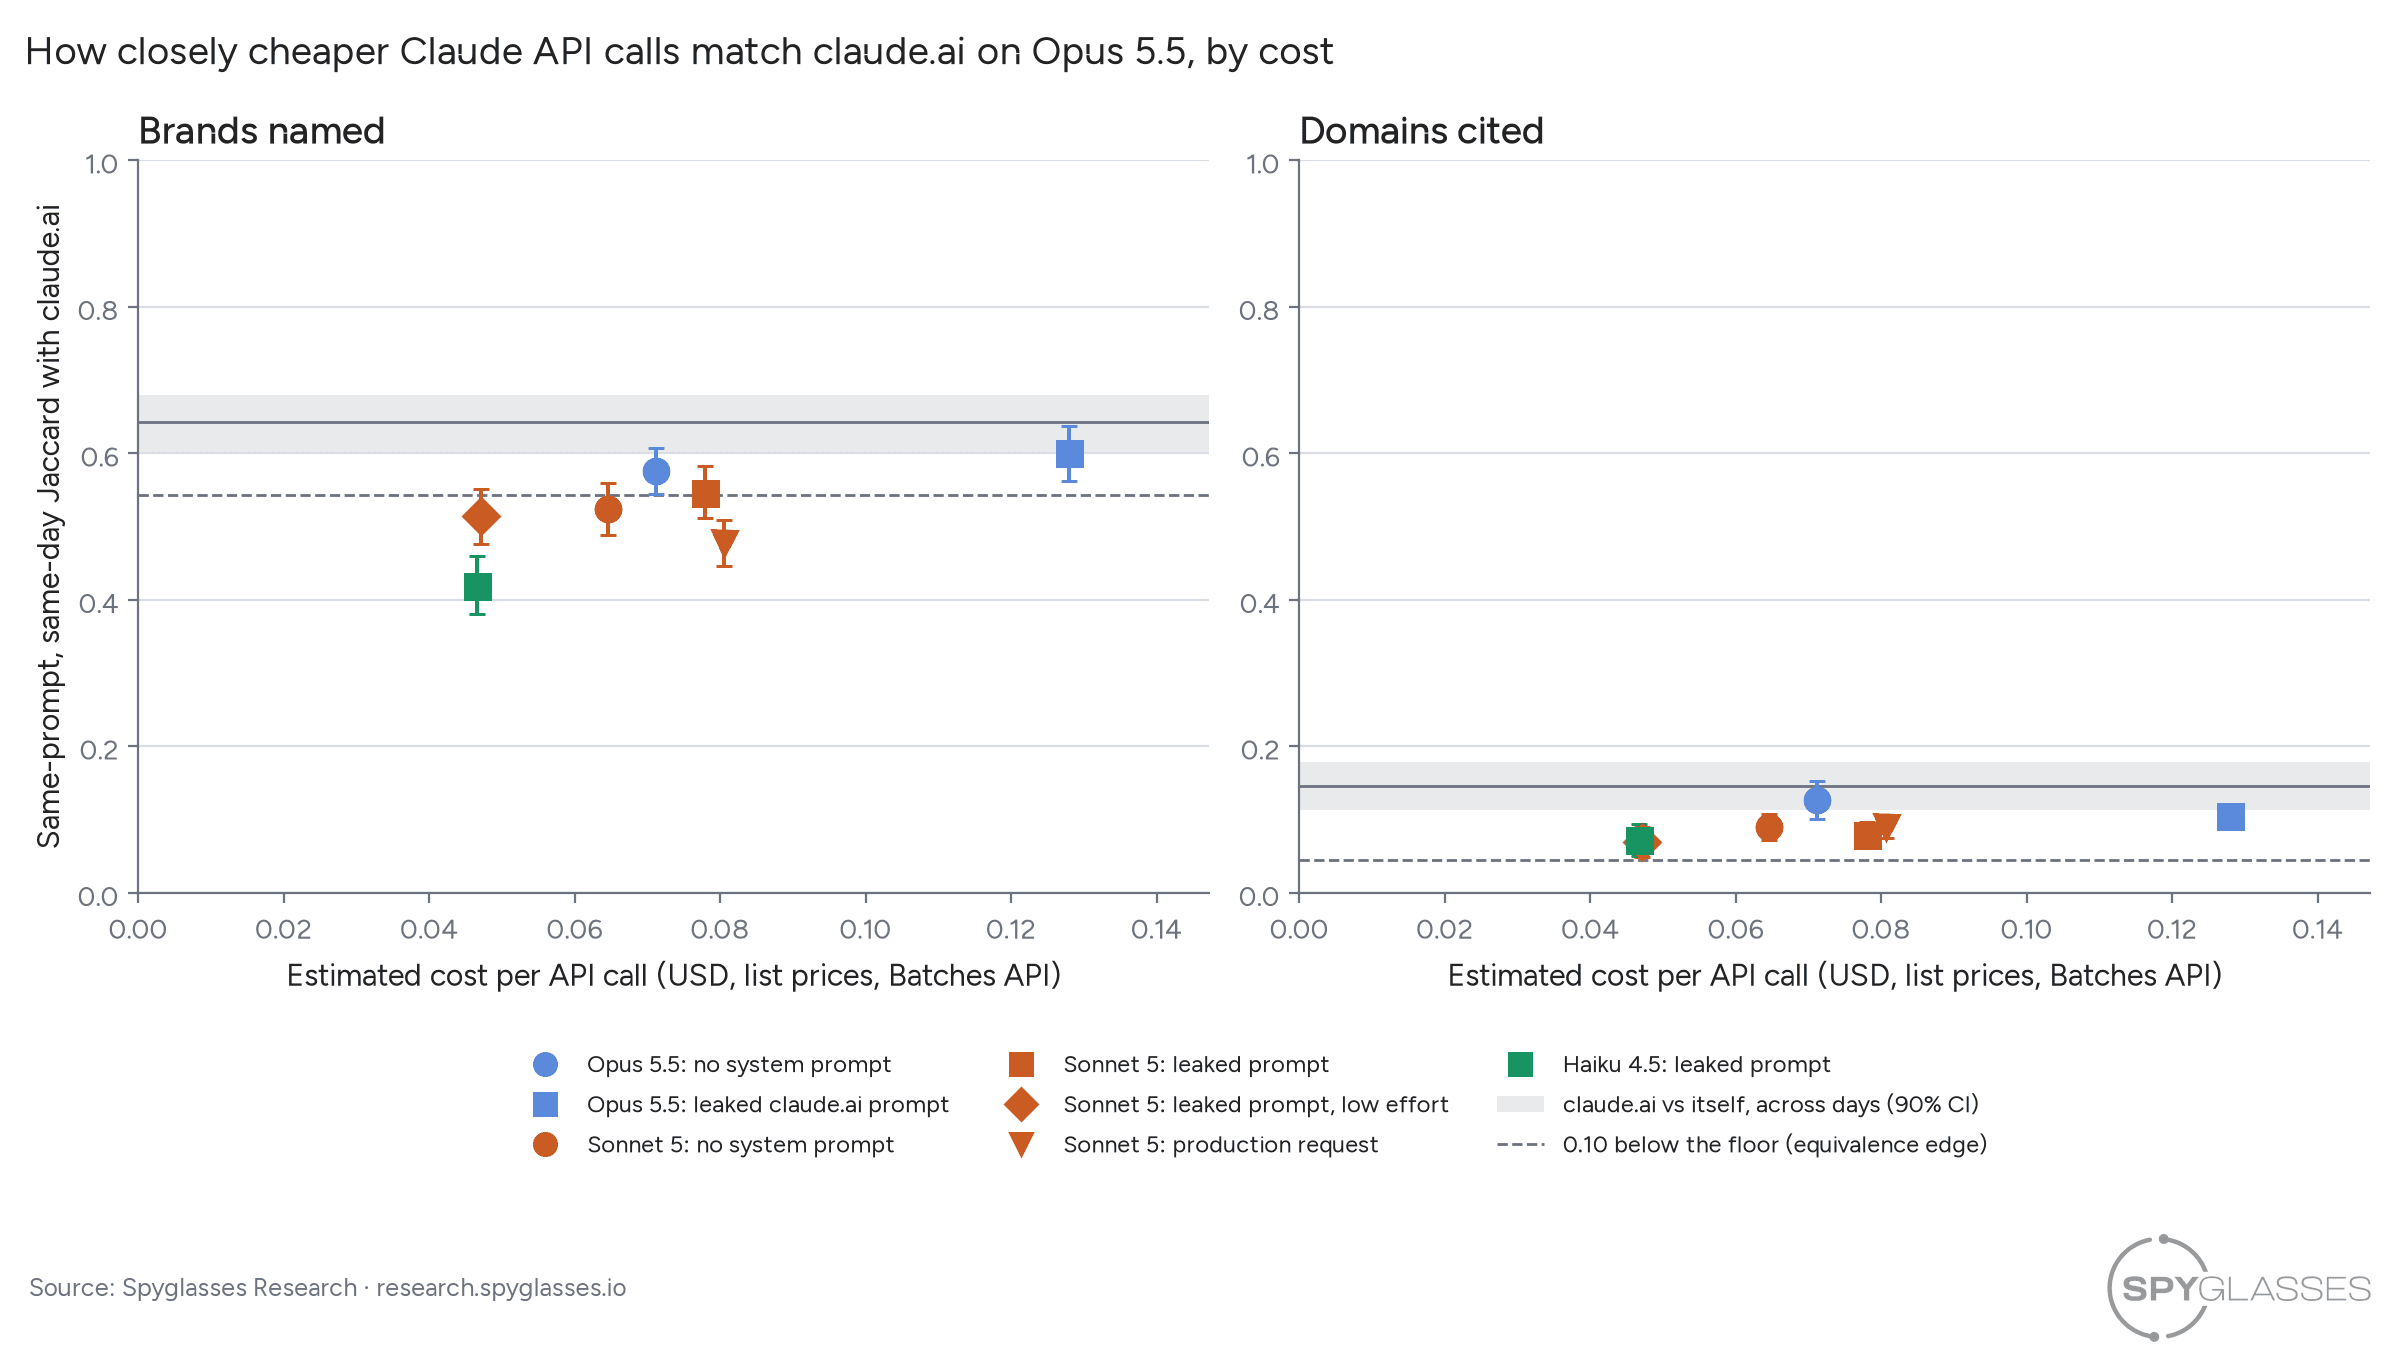
Der übliche Grund, ein kleineres Modell als Ersatz zu nehmen, sind die Kosten. In dieser Studie war die Ersparnis gering. Es handelt sich um Schätzungen, berechnet aus Token- und Suchzahlen zu den Listenpreisen von Anthropic für die Batches API, nicht aus einer Rechnung übernommen.
| Konfiguration | Geschätzte Kosten pro Aufruf (USD) |
|---|---|
| Sonnet 5, ohne Systemprompt | 0,065 |
| Opus 5.5, ohne Systemprompt | 0,071 |
| Sonnet 5, unsere frühere Produktionsanfrage | 0,081 |
| Opus 5.5, geleakter claude.ai-Prompt | 0,128 |
Die Konfiguration, die ohne geleakten Prompt am nächsten an claude.ai lag, war kaum teurer als Sonnet und günstiger als die Anfrage, die wir früher verwendet haben.
Was das für Ihr Claude-Tracking bedeutet
Fragen Sie, von welchem Modell Ihre Claude-Zahlen stammen. Wenn es nicht Opus 5.5 ist, sind die Marken in Ihrem Bericht dann die Marken, die ein claude.ai-Nutzer standardmäßig sieht? In dieser Studie kam keine Sonnet- oder Haiku-Konfiguration, die wir getestet haben, dorthin.
Lesen Sie zitierte Quellen über viele Durchläufe, nie aus einem einzigen. Quellen bewegen sich stark, selbst innerhalb von claude.ai. Bei derselben Frage an zwei verschiedenen Tagen überschnitten sich die zitierten Websites von claude.ai nur zu 0,145 auf derselben Skala von 0 bis 1. Opus 5.5 ohne Systemprompt überschnitt sich mit den Quellen von claude.ai am selben Tag zu 0,126, die Sonnet- und Haiku-Konfigurationen zu 0,069 bis 0,090. Lesen Sie die Ergebnisse zu Quellen als Richtungshinweis. Ein einzelner Durchlauf sagt wenig darüber, welche Quellen Claude zitiert.
Achten Sie auf die Reihenfolge, nicht nur auf die Liste. Eine zuerst genannte Marke wird anders gelesen als eine an sechster Stelle. Opus 5.5 ohne Systemprompt kommt bei der Menge der Marken nah heran, bei der Reihenfolge etwas weniger. Bei der Reihenfolge hatten die Sonnet-Konfigurationen Lücken von 0,136 bis 0,176.
Was wir geändert haben
Spyglasses misst Claude jetzt in der Konfiguration, die die Studie bestätigt hat: Opus 5.5 (claude-opus-5-5) über die API, mit mittlerem Aufwand und ohne Systemprompt. Die getrackte Frage geht genau so an Claude, wie sie geschrieben ist. Claude kann bis zu 10 Websuchen pro Antwort ausführen, und der Standort, den Sie tracken, wird nur an das Suchwerkzeug von Claude übergeben. Unsere frühere Anfrage lief auf Sonnet 5 mit unserem eigenen Systemprompt, und genau für sie hat die Studie eine Markenlücke von 0,165 gemessen.
Was das nicht bedeutet
Die claude.ai-Seite ist ein neues Konto in einer Stadt, Pittsburgh, mit ausgeschaltetem Gedächtnis und ohne Personalisierung, die Ergebnisse beschreiben also claude.ai ohne Personalisierung. Die Studie umfasste 40 synthetische Kauffragen zu B2B-Software über drei Tage, und die Ergebnisse gelten möglicherweise nicht für Konsumgüter, lokale Dienstleistungen, andere Sprachen oder längere Zeiträume.
Die vollständige Methodik, der präregistrierte Plan, die Kostenschätzungen und die veröffentlichten Daten stehen im Forschungsartikel.
Claude ist in jedem AI Visibility Report enthalten, und Claude im Daily Prompt Tracking ist auf Anfrage als Add-on verfügbar. Beides läuft jetzt auf Opus 5.5. Unsere Methodik der Datenerhebung erklärt, wie wir Daten von jeder KI-Plattform erheben. Um Claude zu Ihrem Daily Prompt Tracking hinzuzufügen, kontaktieren Sie uns.