Ihr Claude-Abo kann Marken so tracken wie claude.ai

Jim Wrubel
11/10/2026
Claude ist teuer zu tracken. Von claude.ai gibt es keine abgemeldete Version, die man abfragen könnte. Getrackte Antworten stammen deshalb meist aus bezahlten API-Aufrufen, und die Kosten wachsen mit jeder Frage und jedem Tag.
Viele Teams bezahlen bereits für etwas anderes: ein Claude-Abo. Die Pro- und Max-Pläne enthalten Claude Code, das Fragen nach Zeitplan in der Cloud von Anthropic oder auf einem Computer ausführen kann, ohne dass jemand tippt. Daraus ergibt sich eine einfache Frage. Wenn Sie Ihre Tracking-Fragen mit Ihrem eigenen Abo über Claude Code laufen lassen, sehen Sie dann die Marken, die ein echter Mensch in claude.ai sieht?
Claude Code ist nicht claude.ai. Es hat eigene Anweisungen, ein eigenes Suchwerkzeug und eine eigene Art, aus Suchergebnissen eine Antwort zu machen. Unser Forschungsteam hat es deshalb getestet. Die vollständige Studie ist präregistriert, die Daten sind öffentlich. Hier ist, was wir gefunden haben.
Die wichtigsten Erkenntnisse
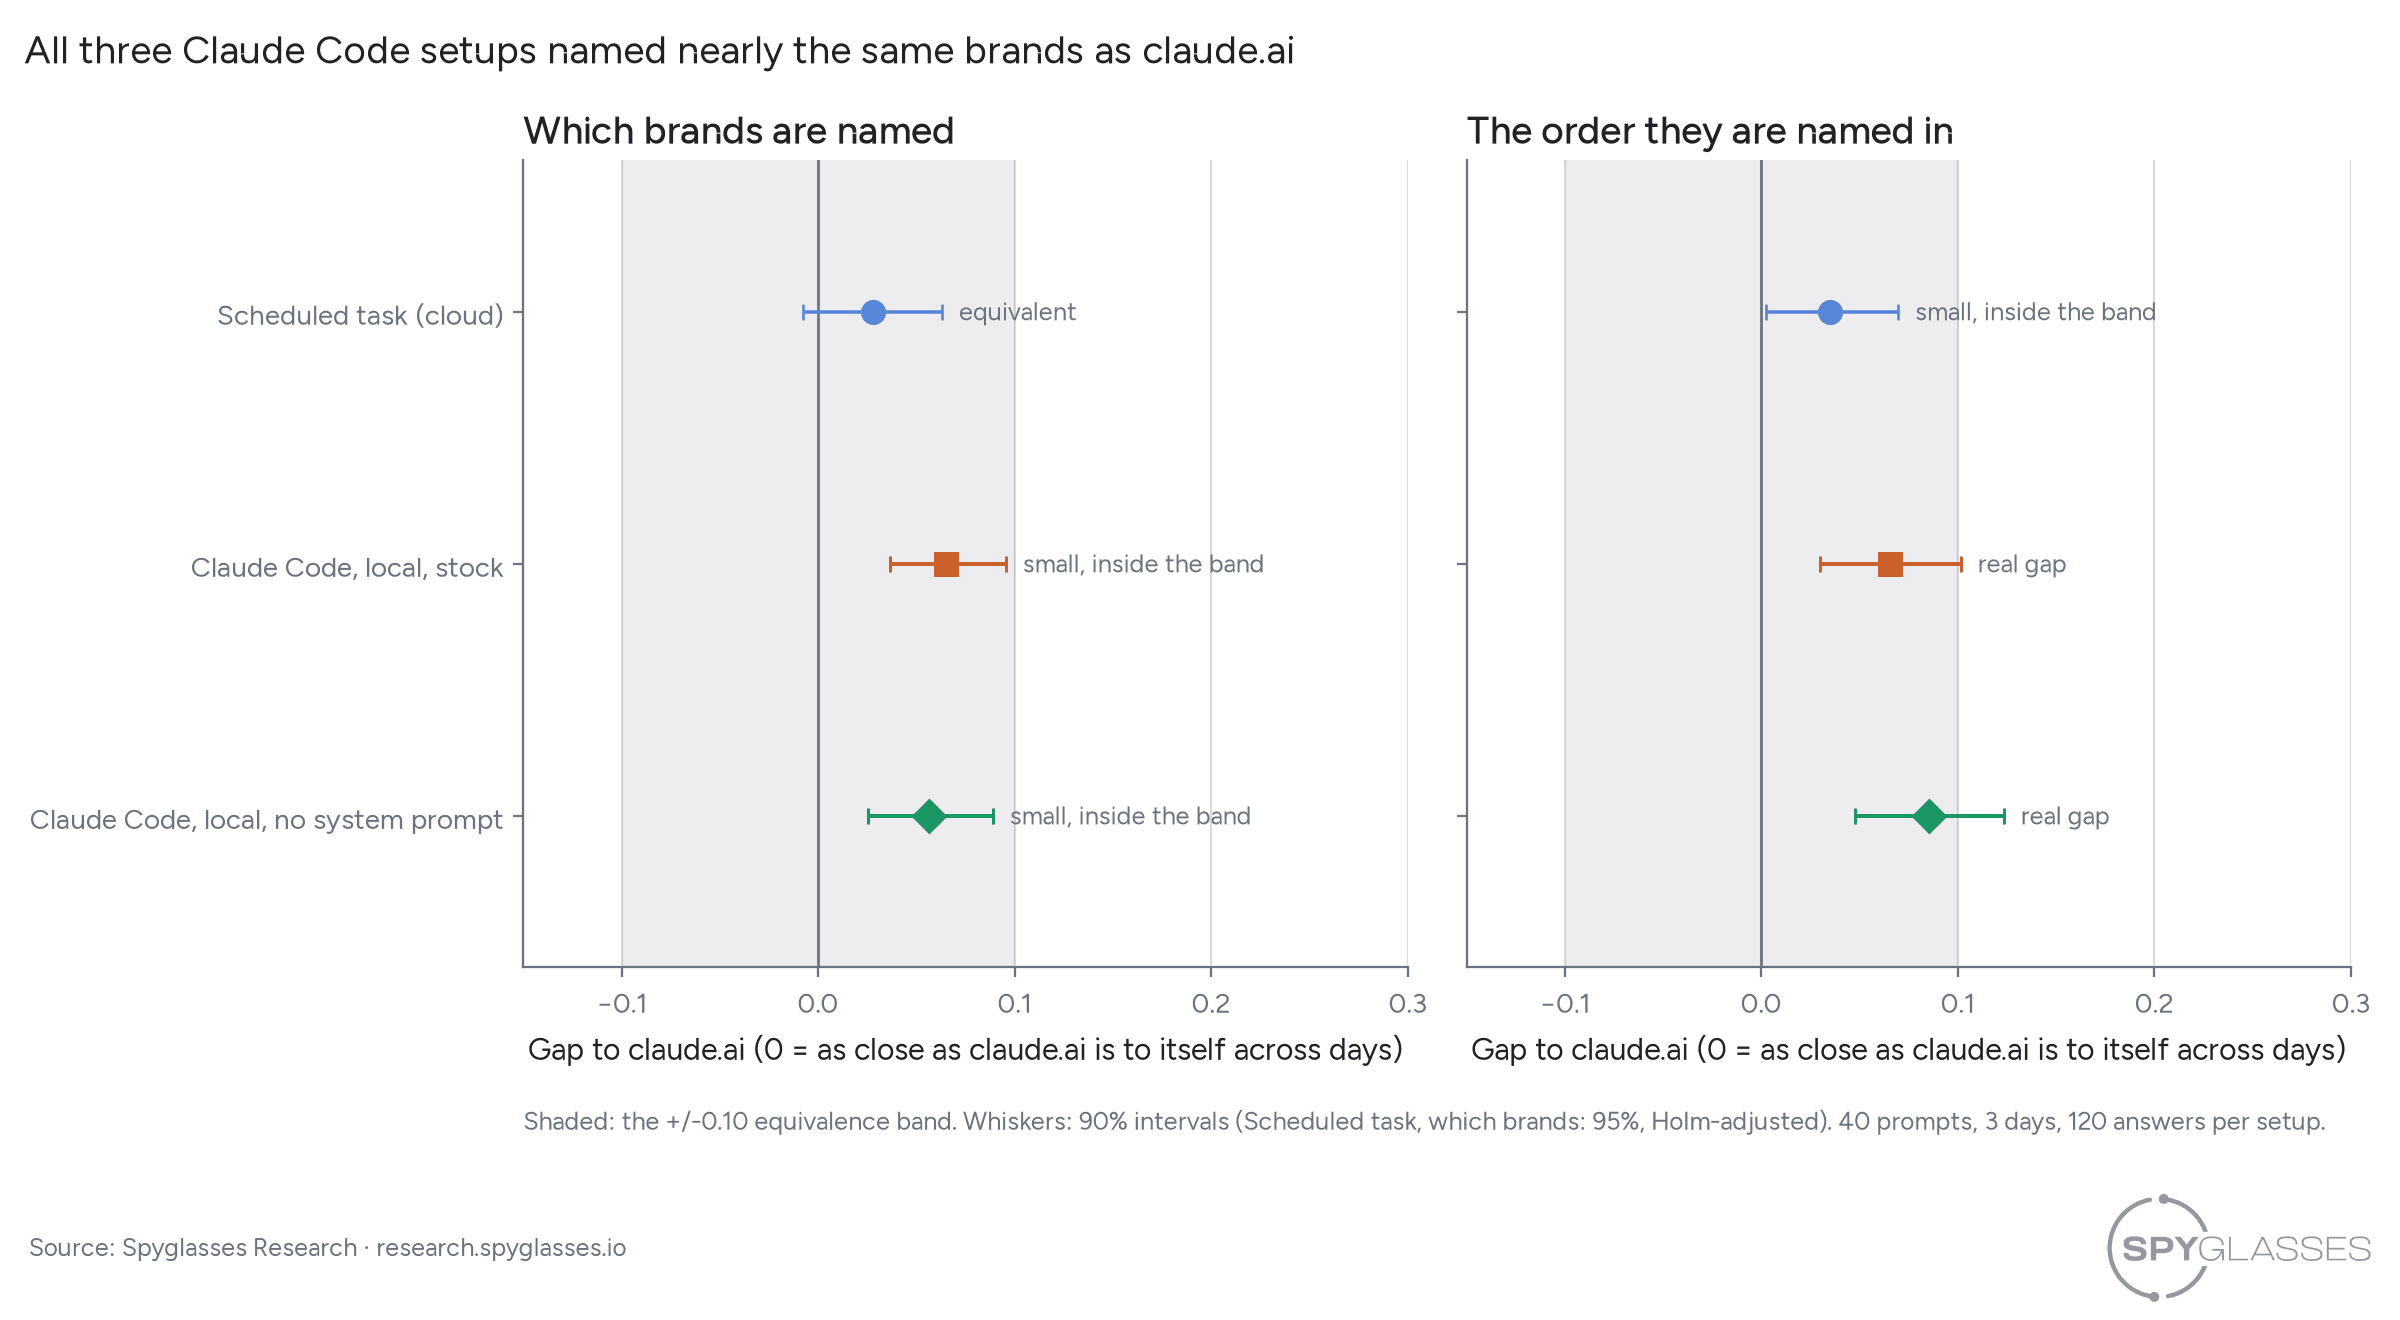
- Eine sorgfältig aufgesetzte geplante Aufgabe in Claude Code nannte bei Kauffragen zu B2B-Software dieselben Marken wie claude.ai, so genau, wie claude.ai von einem Tag zum nächsten mit sich selbst übereinstimmt.
- Ein lokaler Lauf von Claude Code auf einem Computer kam bei den genannten Marken ebenfalls nah heran, bei ihrer Reihenfolge etwas weniger.
- Geplante und lokale Läufe von Claude Code stimmten miteinander überein. Beide können bei den Marken für claude.ai einstehen.
- Claude Code sucht häufiger als claude.ai und zitiert eine etwas andere Mischung von Websites, landet aber bei ähnlichen Marken.
- Der Ansatz eignet sich nicht, wenn der Suchstandort eine Rolle spielt, weil sich für die Websuche von Claude Code kein Standort festlegen lässt.
- claude.ai selbst hat sich in diesem Herbst verändert. Es sucht jetzt mehr und arbeitet ähnlicher wie Claude Code. Jeder Ersatz sollte deshalb im Lauf der Zeit erneut mit claude.ai abgeglichen werden.
Die Studie
Das Team hat 40 Kauffragen aus unserer früheren Claude-Studie wiederverwendet, verteilt auf 20 Softwarekategorien wie CRM, Lohnabrechnung und Endpoint Security. Eine Person hat jede Frage an drei Tagen im November von Hand in claude.ai gestellt, über ein Pro-Konto mit ausgeschaltetem Gedächtnis und ohne Personalisierung. claude.ai war der Maßstab.
An denselben Tagen liefen dieselben Fragen unbeaufsichtigt über Claude Code mit einem Max-Abo, in drei Varianten:
- Eine geplante Aufgabe in der Cloud von Anthropic. Bei dieser Variante muss kein Computer laufen.
- Ein lokaler Lauf mit den Standardeinstellungen von Claude Code.
- Ein lokaler Lauf, bei dem die eigenen Anweisungen von Claude Code durch leere ersetzt wurden.
Insgesamt wurden 600 Antworten in dieser Studie ausgewertet.
Wir haben verglichen, welche Marken jede Antwort nannte, mit einem Überschneidungswert: dem Anteil der Marken, die zwei Antworten gemeinsam haben, von 0 (nichts gemeinsam) bis 1 (dieselben Marken). Der Maßstab war claude.ai selbst. claude.ai gibt nie zweimal dieselbe Antwort, also haben wir zuerst gemessen, wie gut es bei derselben Frage über verschiedene Tage mit sich selbst übereinstimmt. Eine Variante von Claude Code besteht, wenn sie mit claude.ai ungefähr so gut übereinstimmt wie claude.ai mit sich selbst. Den Abstand dazu nennen wir die Lücke. Vor der Datenerhebung haben wir die Toleranz auf 0,10 festgelegt. Bei zwei Antworten, die etwa zehn Marken nennen, entspricht das ungefähr einer ausgetauschten Marke.
Was wir gefunden haben
Eine geplante Aufgabe traf claude.ai
Die Lücke der geplanten Aufgabe lag bei 0,028. Unser präregistrierter Test wertet das als gar keinen Unterschied. Sie nannte dieselben Marken wie claude.ai, ungefähr so beständig, wie claude.ai sie selbst nennt.
Wie die Aufgabe aufgebaut war, spielte eine Rolle. Die Fragen einfach in eine geplante Aufgabe einzufügen, funktionierte in unseren ersten Tests nicht: Sie antwortete aus dem Gedächtnis und ließ die Suche aus. Die funktionierende Version gibt jede Frage an einen neuen Hilfsagenten, mit einer kurzen Anweisung, im Web zu suchen und der fragenden Person zu antworten. Außerdem schaltet sie Benachrichtigungen ab und entfernt die verbundenen Apps, die eine neue Aufgabe standardmäßig übernimmt.
Ein lokaler Lauf kam nah heran
Die Fragen mit den Standardeinstellungen über Claude Code auf einem Computer laufen zu lassen, ergab eine Lücke von 0,065. Das ist ein kleiner, aber echter Unterschied, weiterhin innerhalb der Toleranz. Die Marken stimmten überein. Ihre Reihenfolge stimmte weniger gut: Bei einem Wert, der die zuerst genannten Marken stärker gewichtet, reichten die lokalen Läufe knapp über die Toleranz hinaus, während die geplante Aufgabe innerhalb blieb.
Wenn Ihr Reporting auf die Position setzt, etwa welche Marke zuerst genannt wird, ist die geplante Aufgabe die genauere Entsprechung.
Anders gesucht, ähnliche Marken
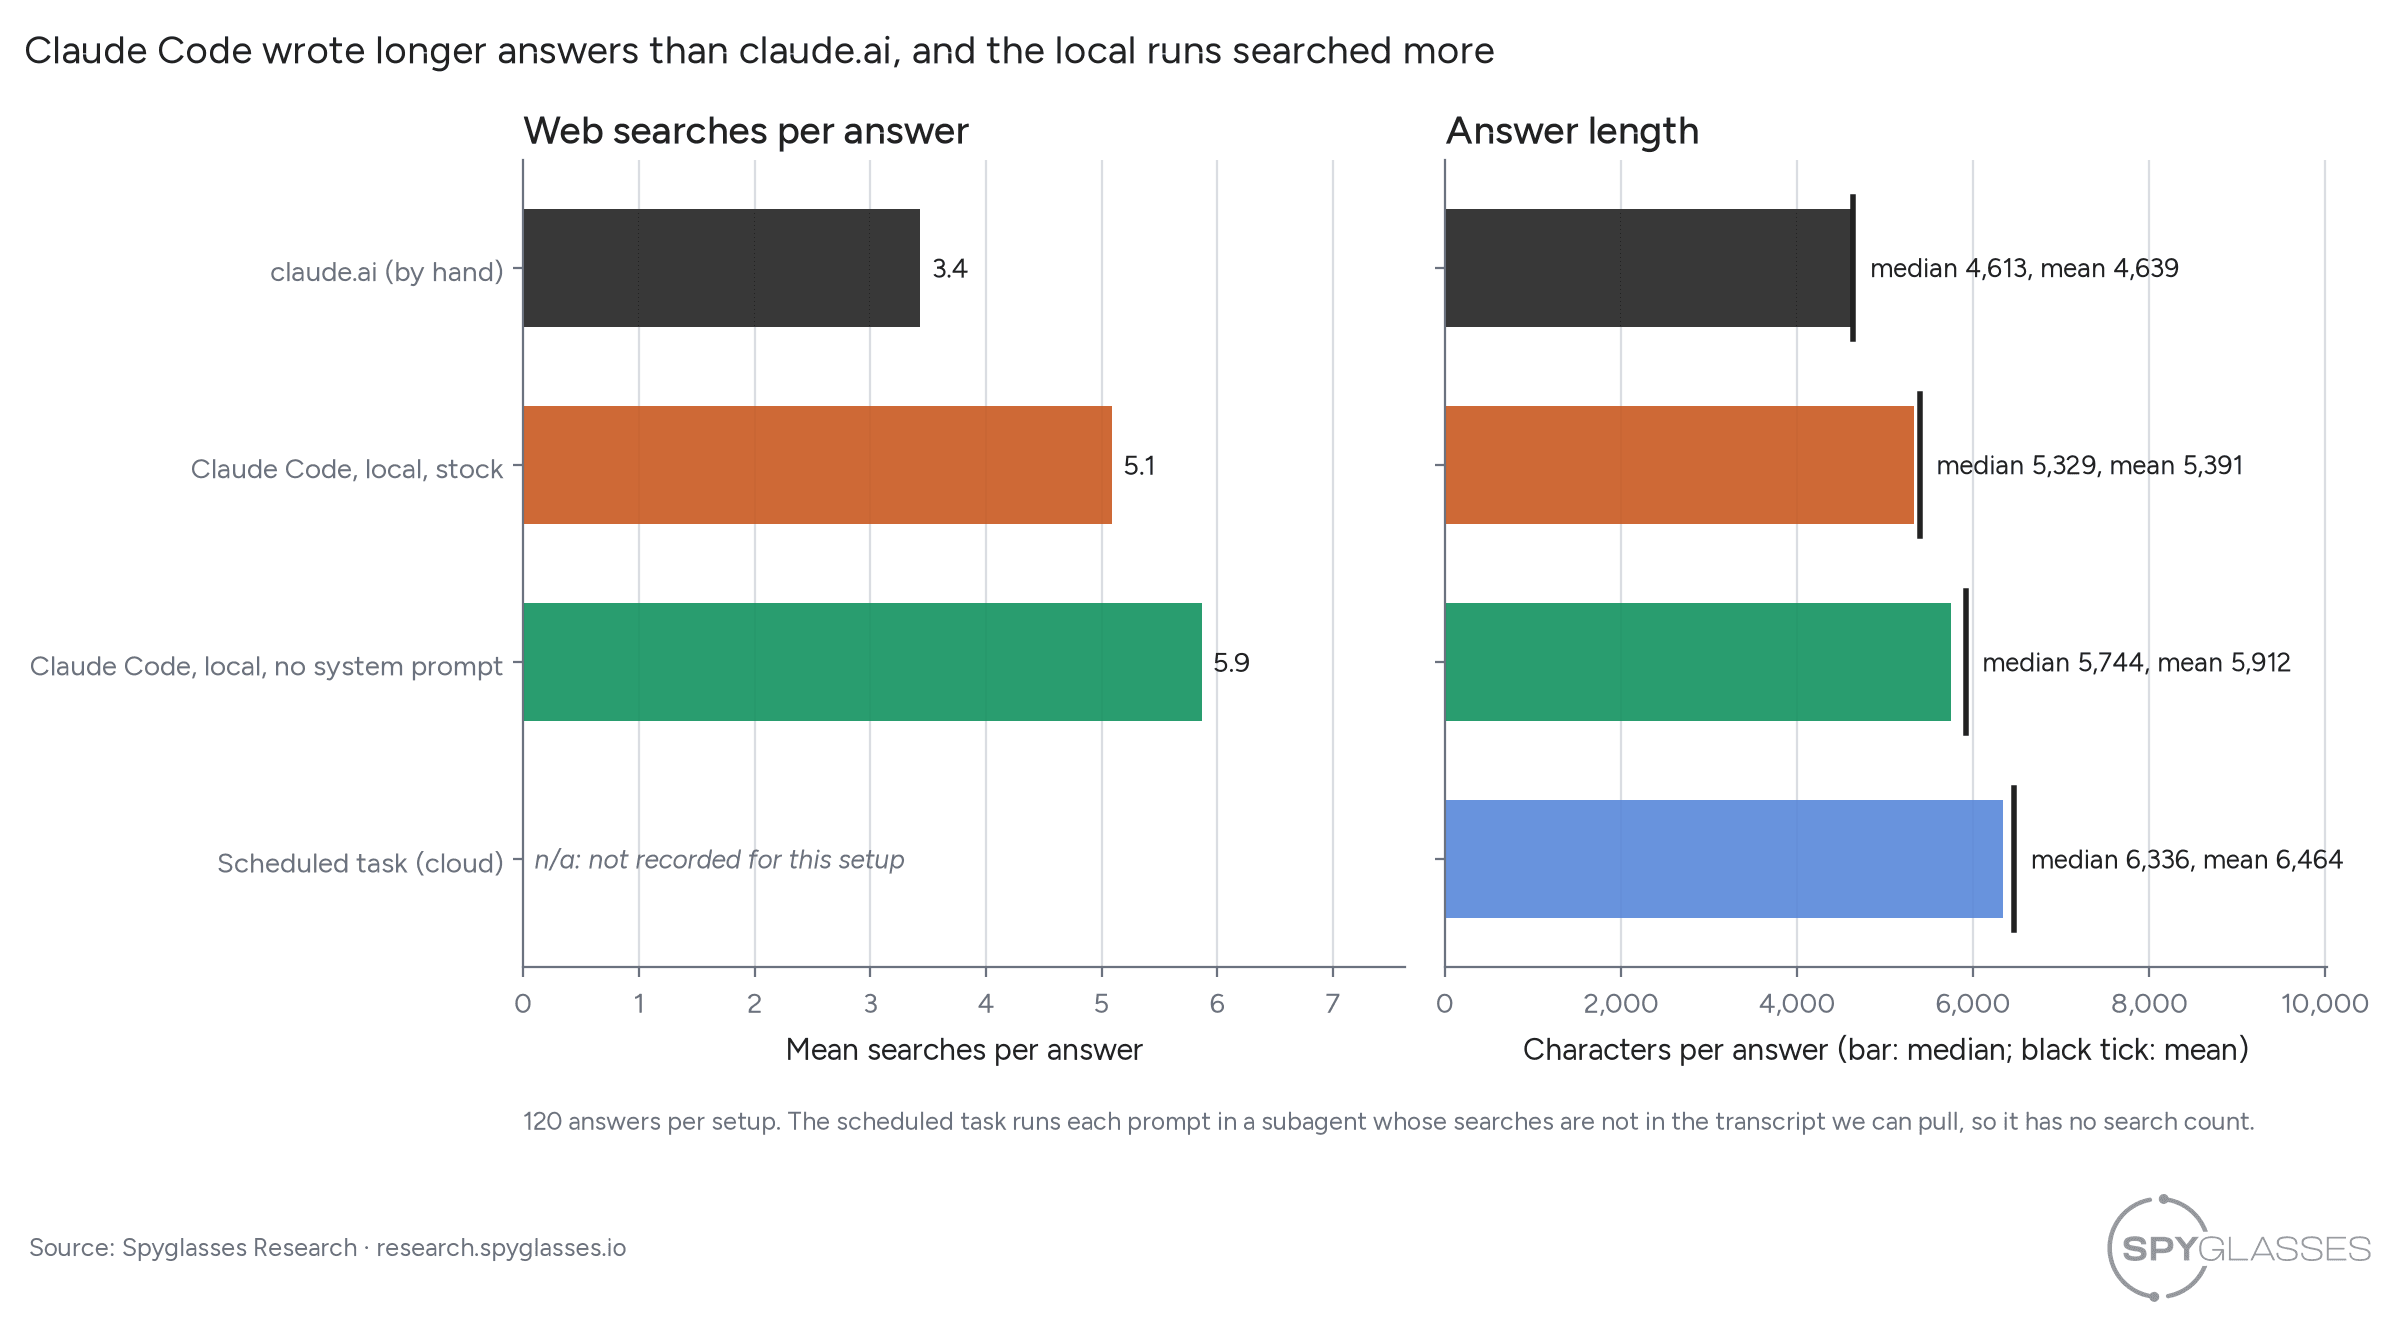
Claude Code arbeitete gründlicher als claude.ai. Die lokalen Läufe kamen im Schnitt auf 5 bis 6 Websuchen pro Antwort, gegenüber 3,4 in claude.ai, und schrieben längere Antworten mit mehr Links. Die zitierten Websites überschnitten sich mit denen von claude.ai weniger als die Marken. Trotzdem lagen die Marken nah beieinander. Für das Marken-Tracking ist das, was Sie in Claude Code sehen, ein guter Hinweis darauf, was ein claude.ai-Nutzer sieht. Wenn Sie tracken, welche Quellen Claude zitiert, lesen Sie die Ergebnisse von Claude Code als Richtungshinweis.
claude.ai hat sich verändert, während wir zugesehen haben
Dieselben Fragen verhielten sich auf demselben Konto im November anders als in unserer Studie vom September. claude.ai führt jetzt etwa 3,4 Suchen pro Antwort aus statt 1,2, und jede Antwort hat gesucht. Im September tat das etwa eine von sechs nicht.
Im September hat Anthropic begonnen, den Chat von claude.ai mit Cowork zusammenzuführen, und Cowork nutzt denselben Agentenaufbau, auf dem Claude Code beruht. Dass dies die Veränderung auf unserem Konto erklärt, ist unsere Deutung, nicht etwas, das Anthropic gesagt hat. So oder so kann sich claude.ai innerhalb weniger Wochen verändern. Das ist ein guter Grund, jede Tracking-Methode mehr als einmal damit abzugleichen.
Was das für Ihr Claude-Tracking bedeutet
Ein Abo kann eine glaubwürdige Quelle für Claude-Markendaten sein. Bei Fragen zu B2B-Software nannte eine sorgfältig aufgebaute geplante Aufgabe in Claude Code die Marken, die ein claude.ai-Nutzer sieht.
Bauen Sie die Aufgabe sorgfältig auf. Geben Sie jeder Frage einen eigenen Hilfsagenten, weisen Sie ihn an, im Web zu suchen, schalten Sie Benachrichtigungen ab und entfernen Sie verbundene Apps, damit Ihre anderen Werkzeuge nicht in die Tracking-Läufe gelangen.
Nutzen Sie es nicht, wenn der Standort zählt. Die Websuche von Claude Code hat keine Standorteinstellung, und eine geplante Aufgabe läuft von einem Ort aus, den Sie nicht wählen können. Für lokale Dienstleistungen, regionale Anbieter oder alles, bei dem die Antwort vom Ort abhängt, nutzen Sie eine Tracking-Methode, die den Suchstandort festlegen kann, etwa die Claude API.
Achten Sie auf die Reihenfolge, nicht nur auf die Liste. Wenn Sie berichten, welche Marke zuerst genannt wird, ziehen Sie die geplante Aufgabe einem lokalen Lauf vor.
Was das nicht bedeutet
Die Studie umfasste 40 synthetische Kauffragen zu B2B-Software über drei Tage, mit einem claude.ai-Konto als Maßstab. Die Ergebnisse gelten möglicherweise nicht für Konsumgüter, lokale Dienstleistungen, andere Sprachen oder personalisierte Konten. Verglichen wurden Marken, nicht Quellen. Ob eine bestimmte Nutzung eines Abos zu den Bedingungen von Anthropic passt, ist eine andere Frage als die, die diese Studie gemessen hat.
Die vollständige Methodik, der präregistrierte Plan und die veröffentlichten Daten stehen im Forschungsartikel.
Claude ist in jedem AI Visibility Report enthalten. Unsere Methodik der Datenerhebung erklärt, wie wir Daten von jeder KI-Plattform erheben. Wenn Sie über das Tracking von Claude für Ihre Marken sprechen möchten, kontaktieren Sie uns.